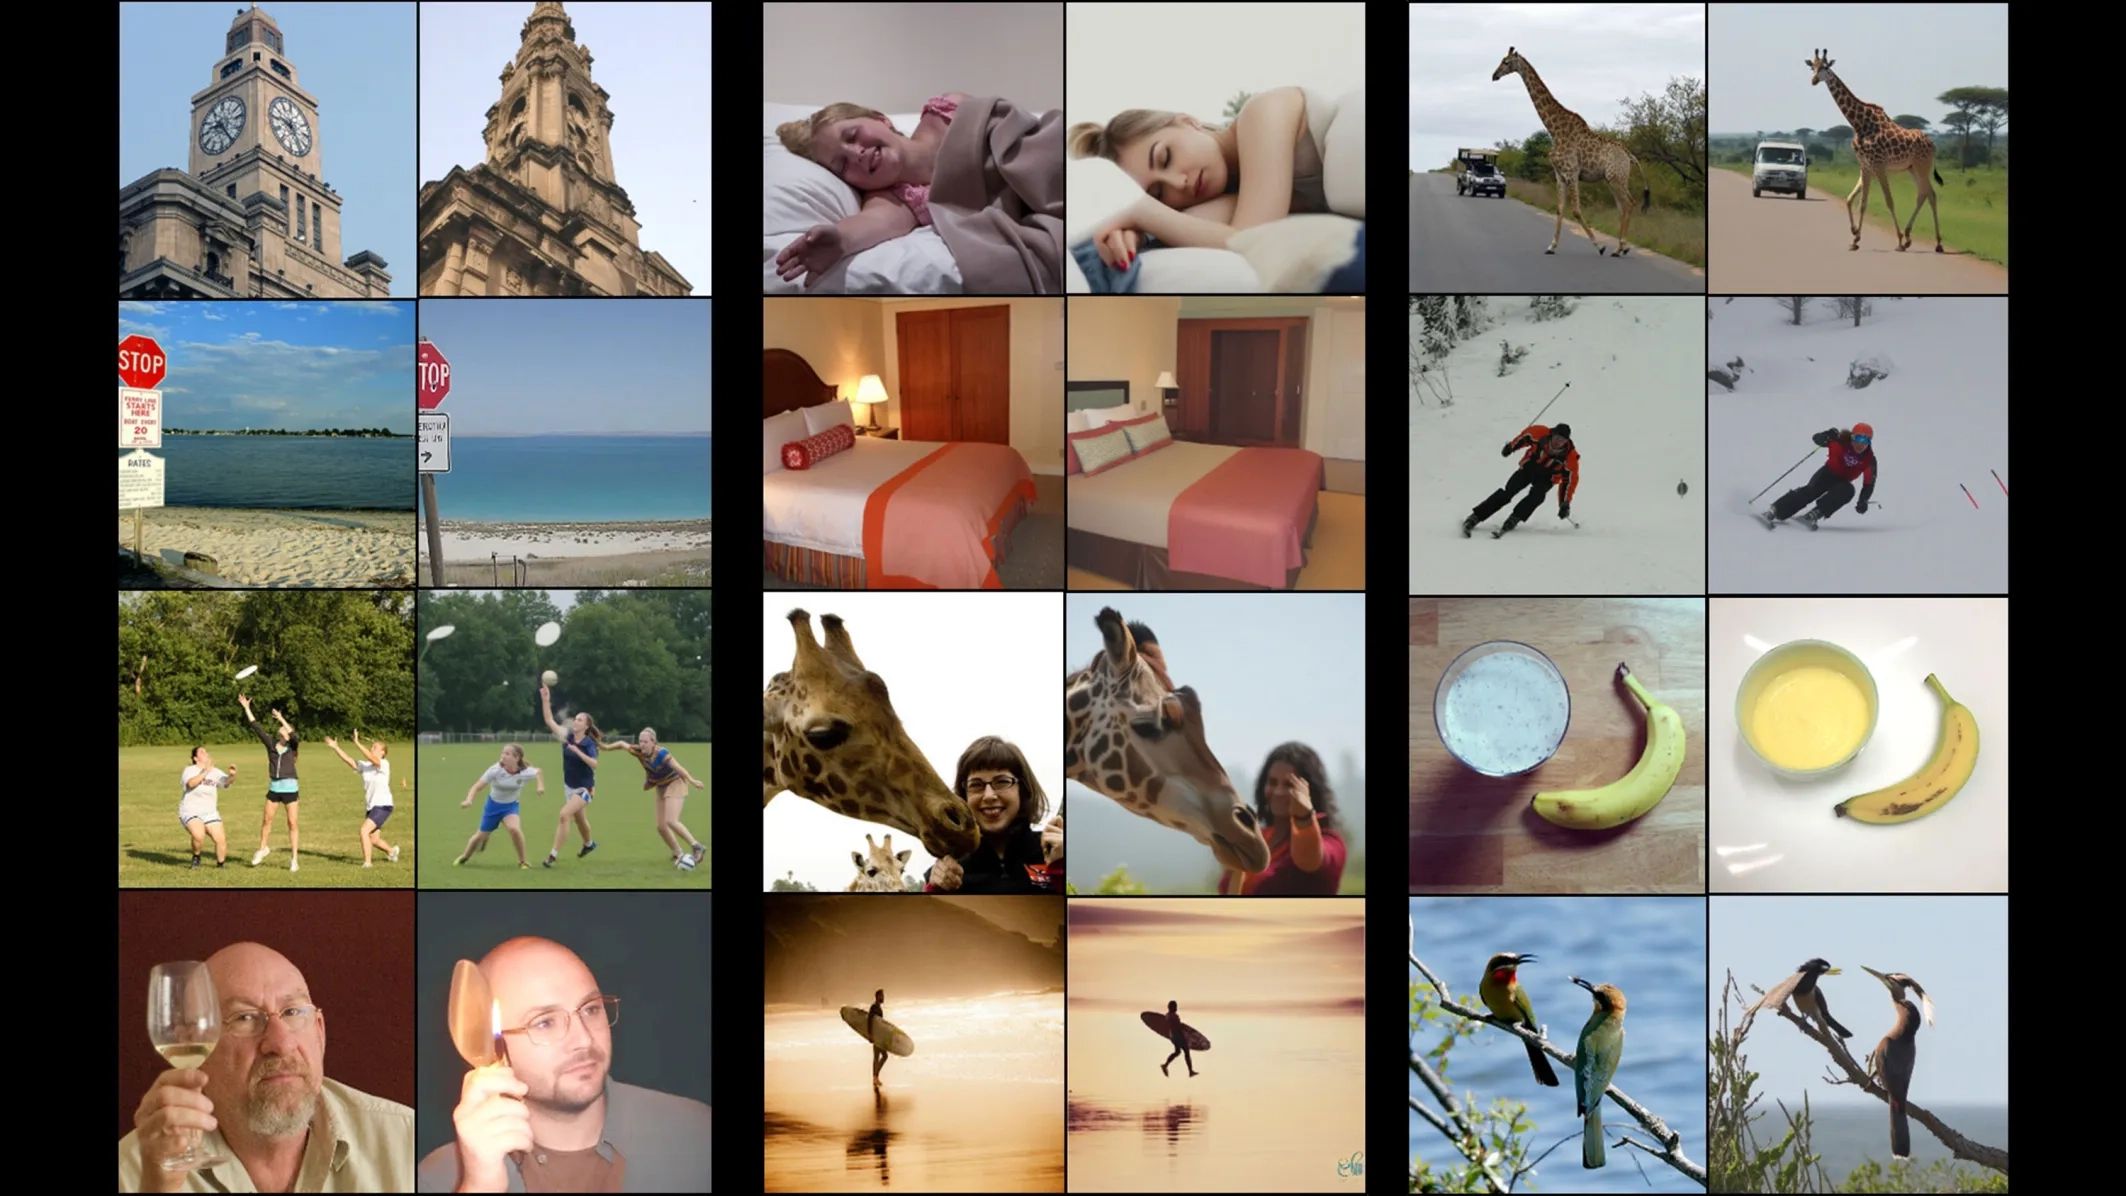
Нейробиологи уже много лет пытаются использовать фМРТ для реконструкции того, что человек видит, а в перспективе — и для восстановления более сложного содержания его сознания. Первые эксперименты позволяли получать лишь размытые и трудноразличимые изображения. Однако развитие магнитно-резонансной томографии и методов машинного обучения постепенно сделало такие реконструкции значительно более точными.
ФМРТ не регистрирует активность отдельных нейронов. Метод отслеживает изменения кровотока и уровня насыщения крови кислородом, которые сопровождают работу различных областей мозга. Получаемое изображение состоит из вокселей — трехмерных элементов объёма, для каждого из которых оценивается соответствующий сигнал. Поэтому пространственное разрешение фМРТ значительно ниже масштаба отдельных нейронов: в традиционных исследованиях размер вокселя мог составлять несколько кубических миллиметров, причем внутри каждого такого объёма находятся тысячи и тысячи нейронов.
Исследователи из Института Вейцмана решили повысить точность реконструкции, используя более современные наборы данных, полученные с помощью фМРТ с более высоким пространственным разрешением. Затем ученые объединили два типа моделей машинного обучения — энкодер и декодер.
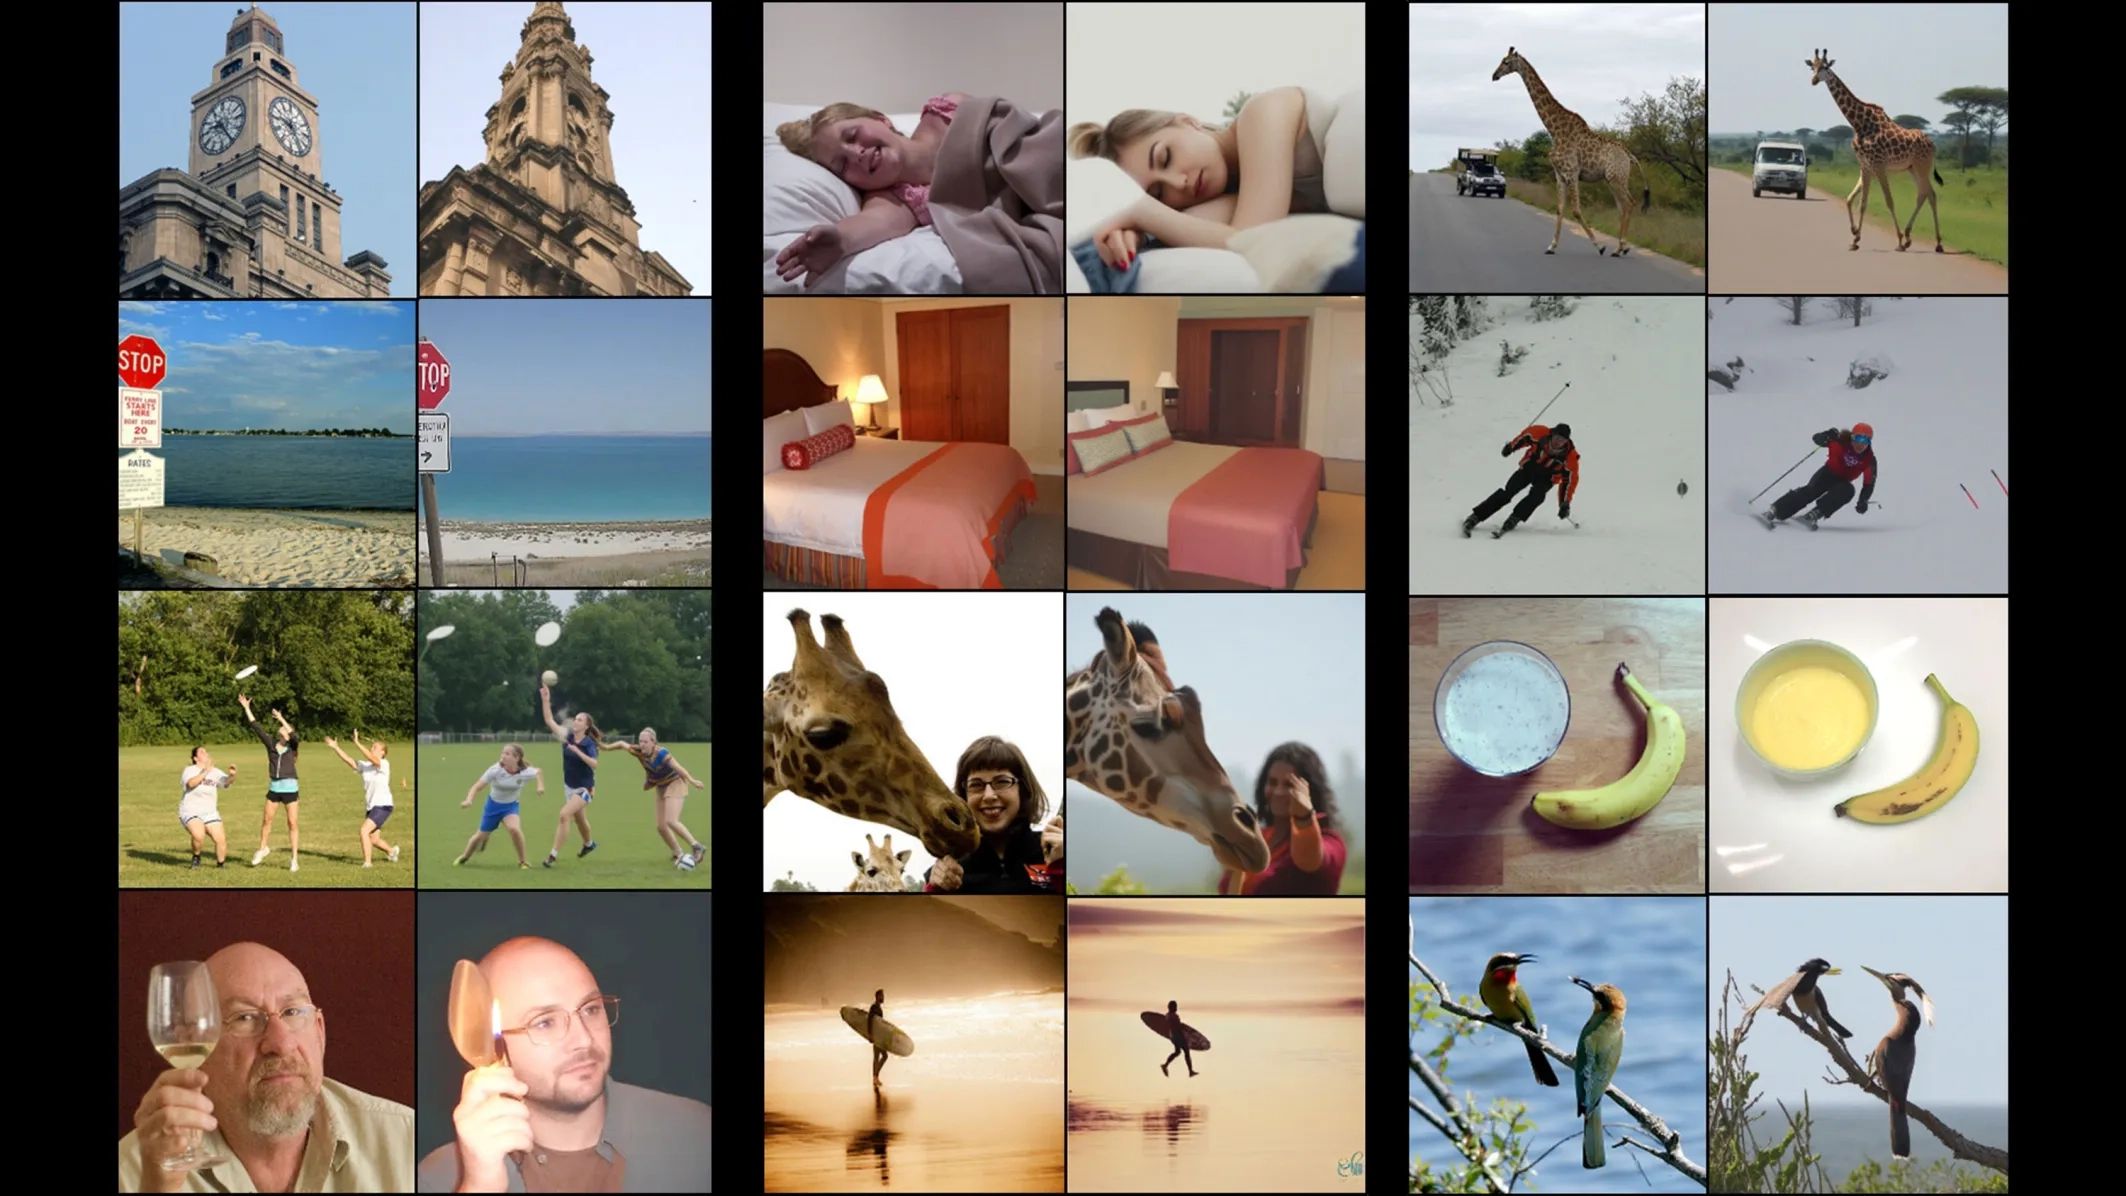
Сначала декодер обучили восстанавливать изображение по данным фМРТ. Для этого ученые использовали результаты сканирования восьми человек, которым во время нахождения в томографе показывали около 9000 изображений. Однако такого объёма данных оказалось недостаточно для полноценного обучения модели. Поэтому исследователи добавили энкодер — модель, которая решает обратную задачу и по изображению прогнозирует, какой сигнал фМРТ должен возникнуть в мозге человека, рассматривающего это изображение.
Такой подход позволяет обучать обе модели совместно. Например, исследователь берет новое изображение леопарда, подает его на вход энкодеру и получает прогноз активности мозга человека, который смотрит на это изображение. Затем этот искусственно полученный сигнал поступает в декодер, который пытается восстановить исходную картинку. На первых этапах результат может лишь отдаленно напоминать леопарда, однако полученные ошибки можно использовать для дальнейшего обучения моделей. После многократного повторения этого процесса качество реконструкции постепенно повышается.
Важное преимущество метода заключается в том, что для обучения энкодера можно использовать гораздо больше изображений, чем реально удается показать испытуемым внутри томографа. Таким образом, модель получает возможность изучать связь между визуальными объектами и характерными паттернами мозговой активности даже в тех случаях, когда соответствующего изображения никогда не было в эксперименте с фМРТ.
Объединив данные из нескольких исследований, ученые также смогли выявить области мозга, которые, по-видимому, выполняют сходные функции у разных людей. Например, одна из областей демонстрировала характерную реакцию на изображения еды, а другая — на изображения, связанные со спортом. Это позволило создать так называемый «универсальный энкодер мозга», который можно адаптировать к новому человеку с гораздо меньшим объёмом индивидуальных данных.
Раньше для настройки системы на конкретного человека могло требоваться около 40 часов фМРТ-данных. Новый подход сокращает необходимое время примерно до одного часа. Это особенно важно для практического применения технологии: исследования с использованием МРТ остаются дорогостоящими, а время работы высокопольного томографа может стоить сотни и даже более тысячи долларов в час, отмечает Technology Review.
Пока речь идет прежде всего о реконструкции визуальной информации, причем в строго контролируемых экспериментальных условиях. Получить из скана фМРТ произвольную мысль человека или «прочитать сознание» в бытовом смысле эта технология пока не позволяет. Более того, мозговая активность существенно различается у разных людей, а качество реконструкции зависит от используемого оборудования, модели и объёма предварительной калибровки.
Тем не менее исследователи уже планируют расширять возможности системы. Следующим этапом может стать переход от статических изображений к видео и аудио. В более отдаленной перспективе ученые хотят научиться реконструировать не только то, что человек непосредственно видит, но и мысленные образы — например, то, что он представляет или видит во сне.
Если это удастся, технология потенциально может оказаться полезной для людей, которые не способны нормально общаться с окружающими. В частности, исследователи рассматривают возможность применения подобных систем для коммуникации с пациентами с синдромом запертого человека, у которых сознание и способность воспринимать окружающее могут сохраняться при практически полной утрате произвольных движений.
Параллельно развивается и другое направление нейротехнологий. В начале 2025 года стартап Based Hardware представил на выставке CES носимое устройство Omi с заявленным «мозговым интерфейсом». Гаджет предназначен прежде всего для повышения продуктивности: он умеет создавать напоминания, резюмировать разговоры, переводить речь и выполнять голосовые команды. Разработчики также заявляли о способности устройства интерпретировать некоторые сигналы, связанные с намерениями пользователя.
До настоящего «чтения мыслей» этим технологиям пока далеко. Но сам принцип уже меняется: ученые учатся не просто фиксировать активность мозга, а связывать сложные пространственные паттерны этой активности с конкретным содержанием восприятия.
Источник: https://hightech.plus/2026/10/06/ii-s-pomoshyu-fmrt-nauchilsya-s-porazitelnoi-tochnostyu-chitat-misl...Если вам понравился материал, кликните значок — вы поможете нам узнать, каким статьям и новостям следует отдавать предпочтение. Если вы хотите обсудить материал —не стесняйтесь оставлять свои комментарии : возможно, они будут полезны другим нашим читателям!